

Präzise Spracherkennung
Ein modernes Sprachmodell transkribiert die Tonspur, trennt Sprecher und setzt Satzzeichen.
- Erkennt die gesprochene Sprache
- Trennt Sprecher
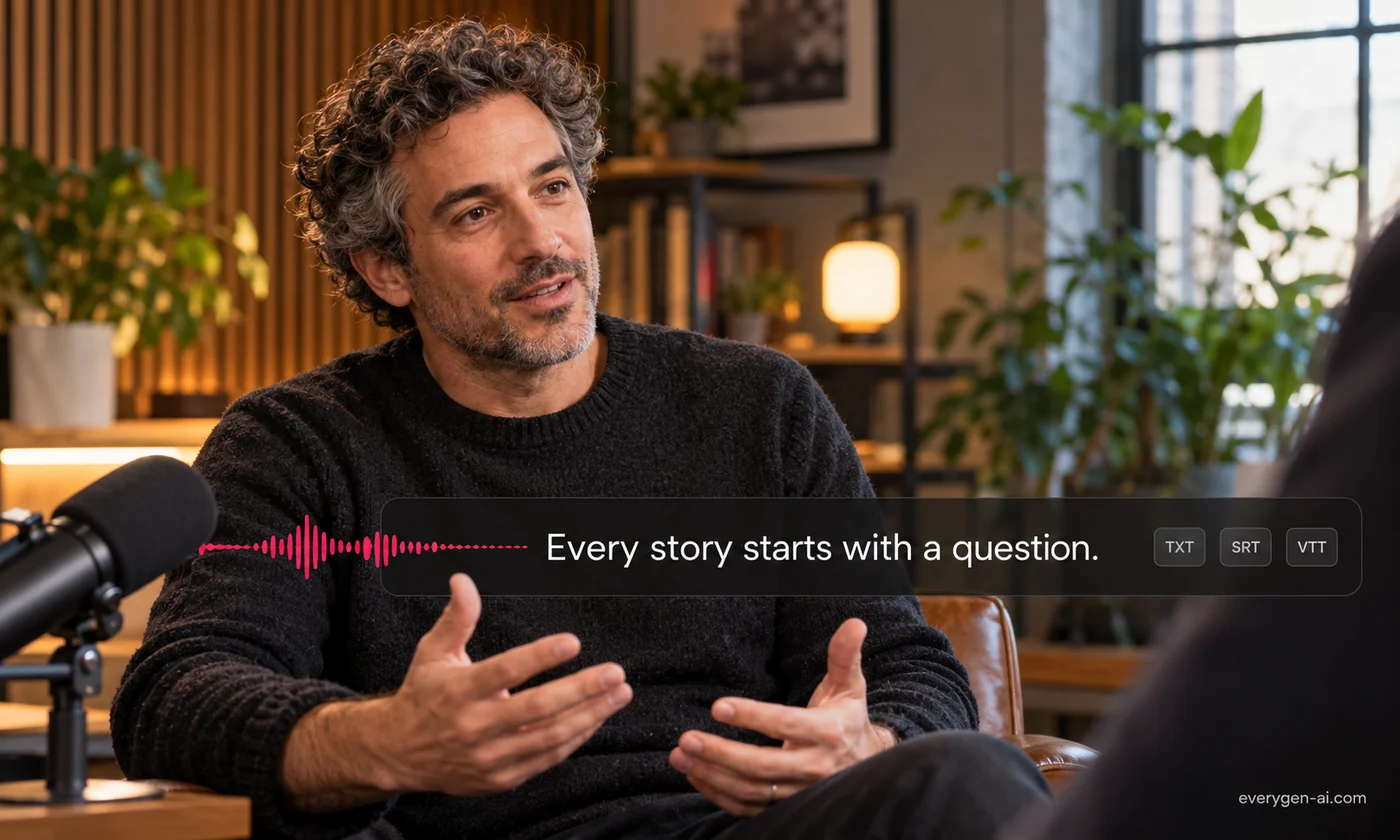
Wandle gesprochene Inhalte in bearbeitbaren Text oder SRT- und VTT-Untertitel um.
Eingaben, Optionen und Ergebnisse.
Ein modernes Sprachmodell transkribiert die Tonspur, trennt Sprecher und setzt Satzzeichen.
Reiner Text eignet sich für Notizen und Zusammenfassungen; SRT und VTT behalten das Timing für Untertitel.
Die meisten Clips sind in Sekunden fertig. Credits richten sich nach der Videolänge und werden vorab angezeigt.
Wähle Einstellungen und prüfe das Ergebnis.
Füge ein Video mit klarer Sprache und bis zu fünf Minuten Länge hinzu.
Behalte die automatische Erkennung oder wähle eine Sprache, dann TXT, SRT oder VTT.
Generiere das Transkript, prüfe Namen und Fachbegriffe und kopiere es.
Wo ein Transkript Zeit spart.
Mache aus einem aufgezeichneten Anruf durchsuchbare Notizen.
Gib Lernenden eine Textfassung des Vortrags.
Mache aus einem Video einen Artikel, ein Skript oder einen Social-Post.
Formate, Credits und Grenzen.
MP4-, MOV- und WebM-Dateien bis 25 MB und fünf Minuten.
Etwa 1–2 Credits pro Videominute, mindestens 1 Credit. Der genaue Preis wird vor dem Start angezeigt.
Ja. Wähle SRT oder VTT für zeitgesteuerte Untertitel.
Klare Sprache wird sehr gut erkannt. Prüfe Namen, Zahlen und Fachbegriffe, besonders bei Hintergrundgeräuschen.
Nein. Lade eine Videodatei hoch, die du verwenden darfst.
Lade ein Video hoch und prüfe das Transkript im Editor oben.